- GitHub 仓库
- openai/whisper
- 总 Stars
- ★ 111,020
- 主要语言
- Python
是什么
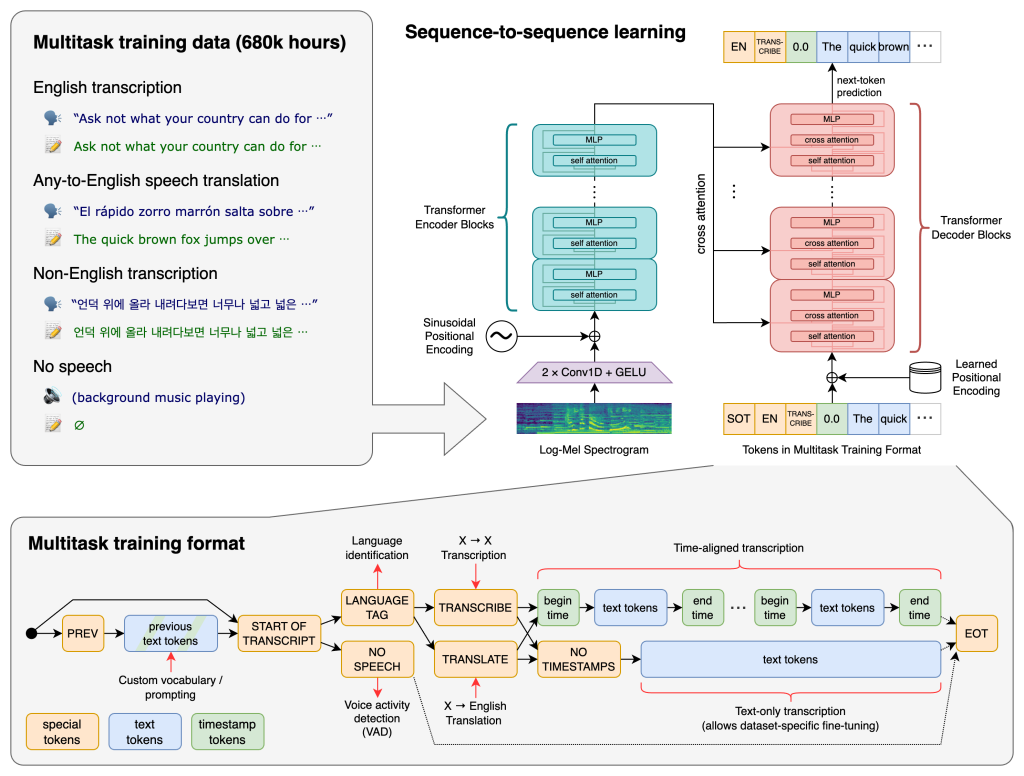
Whisper 是 OpenAI 开源的通用语音识别模型,Transformer 序列到序列架构,在大规模弱监督音频数据上训练,单模型可完成多语言语音识别、语音翻译、语种识别与语音活动检测,11.1 万 star。
能干嘛
pip install openai-whisper 后命令行转录音频/视频字幕,支持 99 种语言;也可作 Python 库集成进应用。
适合谁
需要做字幕、会议记录转写、播客转文字的开发者与内容创作者。
注意点
依赖 ffmpeg,系统需预装,缺了会直接报错;large 模型对显存/内存要求高,纯 CPU 转录速度慢;长音频建议先切分;转录中文时加 –language zh 可减少语种误判,嘈杂音频准确率会下降。对比 Vosk 等轻量离线引擎,Whisper 多语言准确率更高但资源占用大;对比云端 ASR API,Whisper 可完全本地运行、保护隐私。
站长点评
Whisper 是 OpenAI 开源项目里「最实用」的一个:11 万 star,装完就能用,字幕、会议纪要、播客转文字全搞定。本地运行+隐私,是它相对云端 ASR 最大的优势。但 large 模型吃资源是真的,纯 CPU 转录一小时音频能等到天荒地老——个人用 small/base 模型先试试,够用了再上 large。
项目地址:https://github.com/openai/whisper
⬇ 下载区(本站中转)
本站服务器实时中转 GitHub 文件,国内网络也可稳定下载;也可使用右侧官方链接。 本项目遵循 MIT 许可证。
要下载其他 GitHub 项目?试试本站的 GitHub 加速下载工具,粘贴链接即可中转。