- GitHub 仓库
- adbar/trafilatura
- 总 Stars
- ★ 6,976
- 主要语言
- Python
编辑精选常青项目,非当日热榜。
一句话
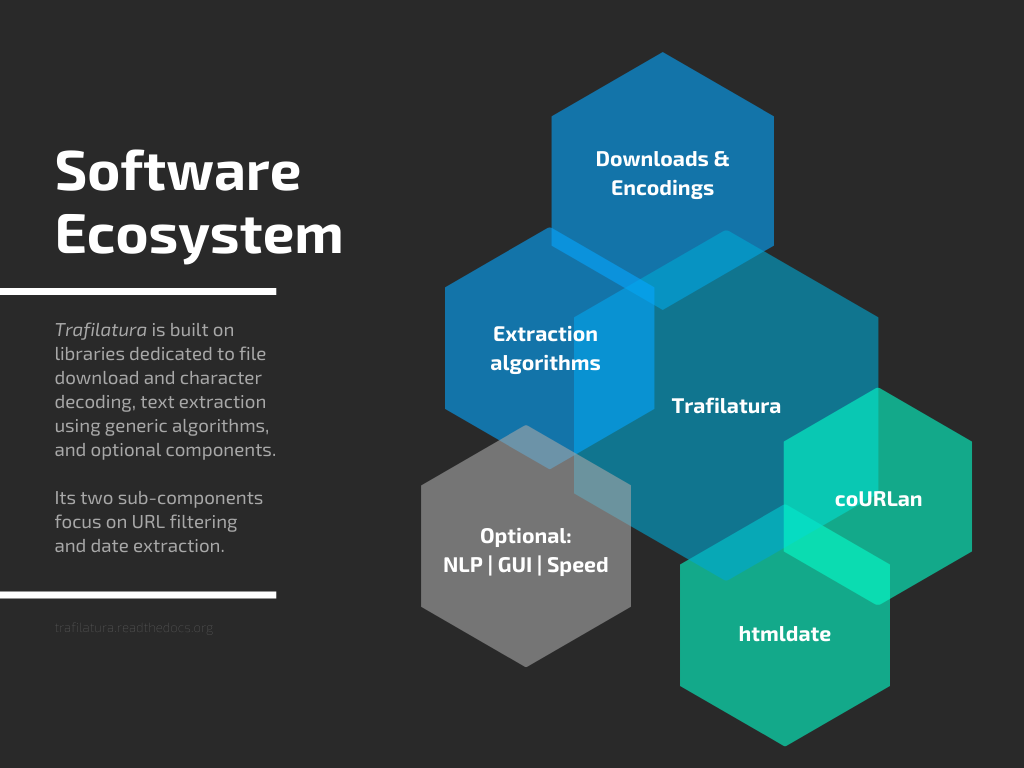
Trafilatura 是一个专做“网页正文提取”的 Python 工具:新闻页、博客页丢进去,广告导航评论全去掉,只留干净正文和元数据,还能直接输出 CSV/JSON/Markdown。截至 2026 年 10 月 17 日核验近 7000 star,Apache-2.0 许可,10 月 6 日仍在提交。
核心玩法
命令行一行搞定,也能当库集成进爬虫管线;多语言支持,中文页面提取效果靠谱;去重、语言检测、作者提取一条龙;内存占用小,适合批量跑。
适合谁
适合做新闻聚合、舆情分析、语料构建的人;也适合爬虫工程师拿它当“正文提取”环节的标准件。
踩坑提醒
强反爬、重度 JS 渲染的页面先过渲染层再喂给它,它只管提取不管抓取;极端版式(比如小说站分章)偶发漏段,重要语料抽查一下;并发开太高先看目标站脸色。
站长点评
正文提取是个“看起来简单做起来全是坑”的活,Trafilatura 是这个细分领域口碑最好的开源方案。对比 readability-lxml 这种老将,它在多语言和元数据上更完整。7000 star 不算多,但用过的人基本都留下了——小而美的典型。
⬇ 下载区(本站中转)
本站服务器实时中转 GitHub 文件,国内网络也可稳定下载;也可使用右侧官方链接。 本项目遵循 Apache-2.0 许可证。
要下载其他 GitHub 项目?试试本站的 GitHub 加速下载工具,粘贴链接即可中转。