- GitHub 仓库
- Niko1221/Strata
- 总 Stars
- ★ 26,261
- 主要语言
- C++
编辑精选,非当日热榜。
是什么
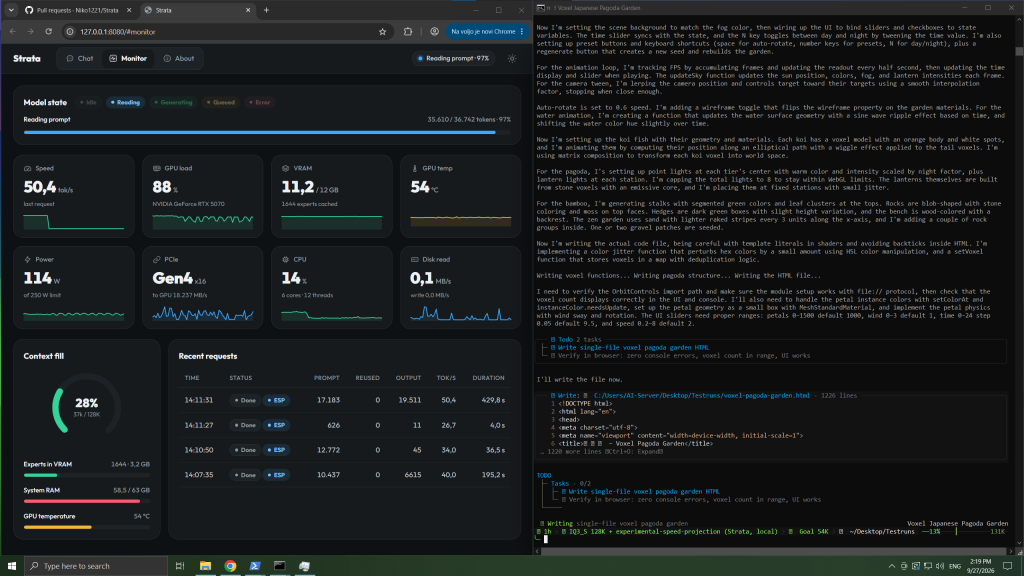
Strata 干的是一件听起来很贵的事:在你家里的游戏 PC 上跑 1250 亿参数的大模型 Qwen3.8-Flash-Next。这种量级的模型平时得上服务器,它做成 Windows/Linux 一键安装,装好后在本机起一个兼容 OpenAI/Anthropic 协议的 API,聊天、写代码、看图、对接 coding agent 都行,数据不出本机。截至 2026 年 10 月 17 日核验 2.6 万 star,MIT 许可。
实测数据
作者在两台普通游戏 PC 上实测并公开了完整数据:RTX 5070(12GB 显存)+ Ryzen 5 7600,Q2_0 量化下输出 94 tokens/s、读取 prompt 2650 tokens/s;AMD RX 9070 XT(16GB)+ Ryzen 9 3900X,输出 60 tokens/s。仓库里还有各量化版本的速度表和社区实测汇总,数字不是拍脑袋的。
适合谁
适合显卡显存 12GB 起步、想本地跑大模型又不想折腾 llama.cpp 一堆参数的人;也适合对数据隐私敏感、想把 coding agent 接到本地模型的开发者。
值得注意
- 硬件门槛:12GB 显存起步,显存越大越快(作者称 RTX 3090 24GB 能到 100–140 tokens/s);模型文件几十 GB,硬盘空间和下载带宽先准备好。
- 速度数字别照搬:那是作者两台机器的实测,你的卡、你的量化版本不同,结果就不同,上手先跑它自带的速度表对一下。
- 有中文文档:README.zh-CN.md 是官方维护的,中文用户友好。
站长点评
对比 Ollama 和 LM Studio 这类“小模型启动器”,Strata 的差异化是直接把 125B 级别的大参数模型塞进消费级显卡——这在一年前是想都不敢想的事。一键安装 + 本地 API 的形态,等于把“本地大模型”从极客玩具变成了普通人能用的工具。实在话:125B 再强也是量化版,别指望它全面超越云端旗舰模型;它的正确用法是隐私场景和断网场景的主力,而不是云端模型的替代品。
⬇ 下载区(本站中转)
本站服务器实时中转 GitHub 文件,国内网络也可稳定下载;也可使用右侧官方链接。 本项目遵循 MIT 许可证。
要下载其他 GitHub 项目?试试本站的 GitHub 加速下载工具,粘贴链接即可中转。