- GitHub 仓库
- google/langextract
- 总 Stars
- ★ 39,338
- 主要语言
- Python
结论先说:Google 的 LangExtract 是 2025 年 7 月发布的 Python 库,16 个月攒下 39,338 星,专门让大模型从非结构化文本里抽结构化信息,而且每条结果都能定位回原文。
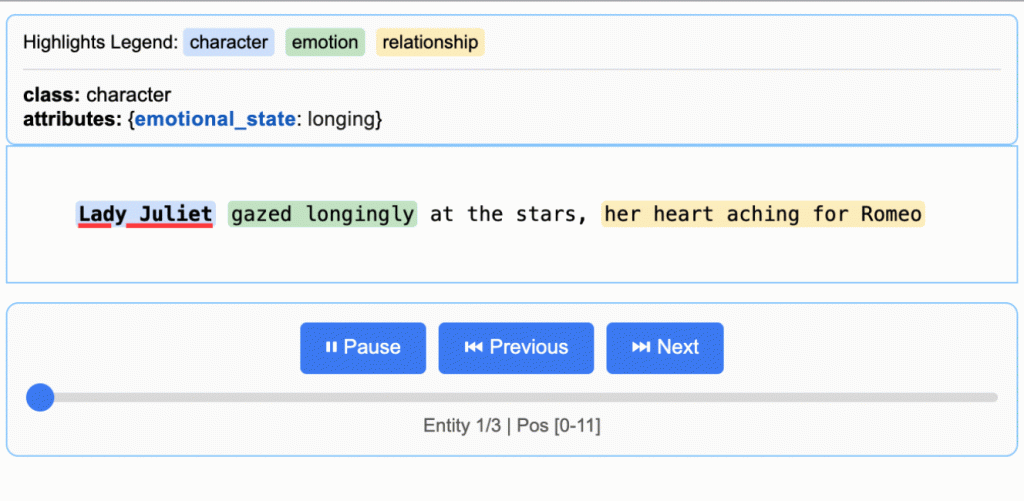
是什么:用大模型按你给的提示和示例抽实体、关系和属性的工具库,输出结构化数据,附带可交互的可视化页面。
能干嘛:抽病历、合同、论文里的关键信息;长文档分块并行抽取;生成 HTML 可视化,抽出的实体在原文里高亮;支持 Gemini、OpenAI,也能接本地 Ollama 模型。
适合谁:做检索增强生成、数据清洗、科研文献整理的人;需要“抽出来的东西可核查”的团队。
注意点:云端模型要 API Key,大批量建议走 Vertex AI 批量接口省成本;示例质量直接决定抽取质量,提示里要写明按原文原话抽、不改写;模型推断的信息要靠定位校验过滤,没定位回原文的就别要。
LangExtract 和直接让模型抽有什么不同?
它强制每条抽取对应原文位置,附带交互可视化复核;普通做法抽完就完事,错了也不知道错在哪;它还支持多遍抽取提召回,长文档能并行处理。
站长点评:我挑它是因为 39,338 星、16 个月攒下近 4 万星,增速说明大家确实被“抽不准、没法验”折磨过;提醒一句,它不是免费午餐,云端用量大了要算好 Key 的账。
⬇ 下载区(本站中转)
本站服务器实时中转 GitHub 文件,国内网络也可稳定下载;也可使用右侧官方链接。
📦 源码包(默认分支 ZIP)官方下载
项目信息暂时获取不到,本站下载稍后再试;可先用官方链接。
要下载其他 GitHub 项目?试试本站的 GitHub 加速下载工具,粘贴链接即可中转。