- GitHub 仓库
- jina-ai/reader
- 总 Stars
- ★ 12,260
- 主要语言
- TypeScript
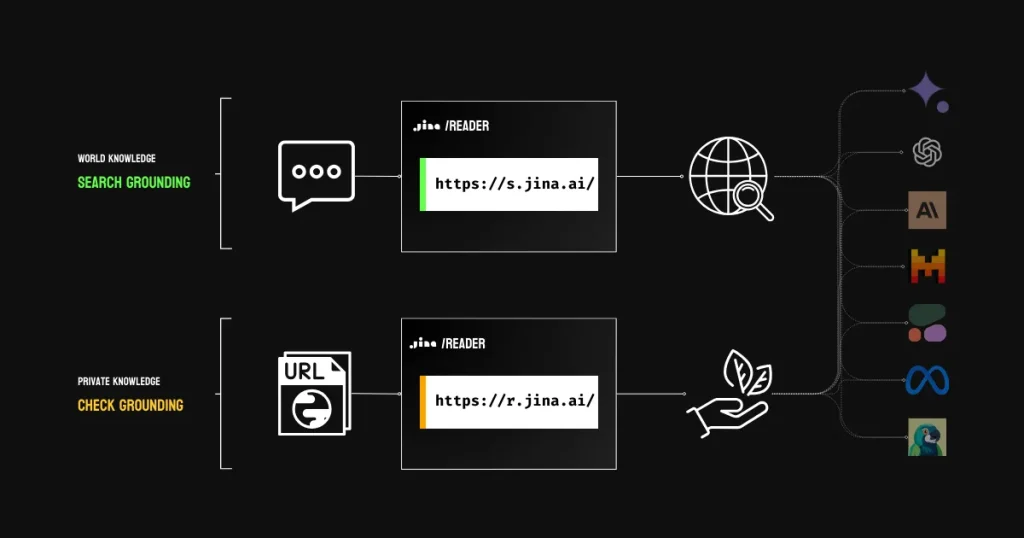
结论先说:Jina Reader 是把任意网址转成大模型友好文本的开源工具,12,260 星,TypeScript 编写,Apache-2.0 协议。用法极简:在网址前面加 r.jina.ai/ 前缀,返回的就是干净的 Markdown;还能用 s.jina.ai/ 直接搜。线上服务免费、稳定,是 Jina AI 的核心产品之一。
它是什么:Jina AI 开源的 Reader 服务:读网页(无头 Chrome 或轻量抓取二选一)、PDF、Word、Excel、PPT,图片还能用视觉模型配文字说明。
能干嘛:给 Agent 和 RAG 系统喂干净的网页正文;搜索时直接返回前 5 条结果的全文,不用自己再抓;支持 JSON 模式、截图、按 CSS 选择器只取一部分、按 token 预算截断;也能用 Docker 自托管。
适合谁:做 AI 搜索、RAG、Agent 的开发者;需要批量把网页转 Markdown 的人;不想自己维护爬虫与反爬的人。
注意点:开源分支最近一次提交在 2026 年 5 月(2026 年 4 月与 SaaS 代码重新同步后),代码本身已稳定,线上服务在持续维护;免费服务有速率限制,大量调用先看官方限流说明;只拿公开内容,别用来绕过付费墙。
Reader 和直接爬网页比强在哪?
不用自己处理浏览器渲染、反爬、JS 和 CSS,单页应用也能读;搜索直接给全文而不是标题摘要;输出格式能调(Markdown、JSON、纯文本),还能按 token 预算截断,喂给模型之前不用再洗一遍。
站长点评:我挑它是因为做 AI 应用最烦的就是喂数据,网页结构千奇百怪,Reader 一行前缀就解决了。12,260 星、Apache-2.0,自托管也有 Docker 文件。先用免费的线上服务试,量上去了再考虑自托管。
懒得一步步折腾?这几个工具本站有现成部署包
站长把 n8n、Immich、Stirling-PDF 的部署过程打包好了:docker-compose、一键脚本、中文说明一应俱全,下载解压就能跑,单包 9.9 元、三包合集 19.9 元。
⬇ 下载区(本站中转)
本站服务器实时中转 GitHub 文件,国内网络也可稳定下载;也可使用右侧官方链接。 本项目遵循 Apache-2.0 许可证。
要下载其他 GitHub 项目?试试本站的 GitHub 加速下载工具,粘贴链接即可中转。